Як розпізнати старий скан документа, якщо OCR пропускає слова і рядки
Старі скани, машинописні сторінки та архівні копії часто розпізнаються з помилками: OCR пропускає рядки, плутає символи й не бачить фрагменти тексту. Розповідаємо, як перевірити якість скану, підготувати зображення, налаштувати OCR і проконтролювати результат без втрати важливої інформації.
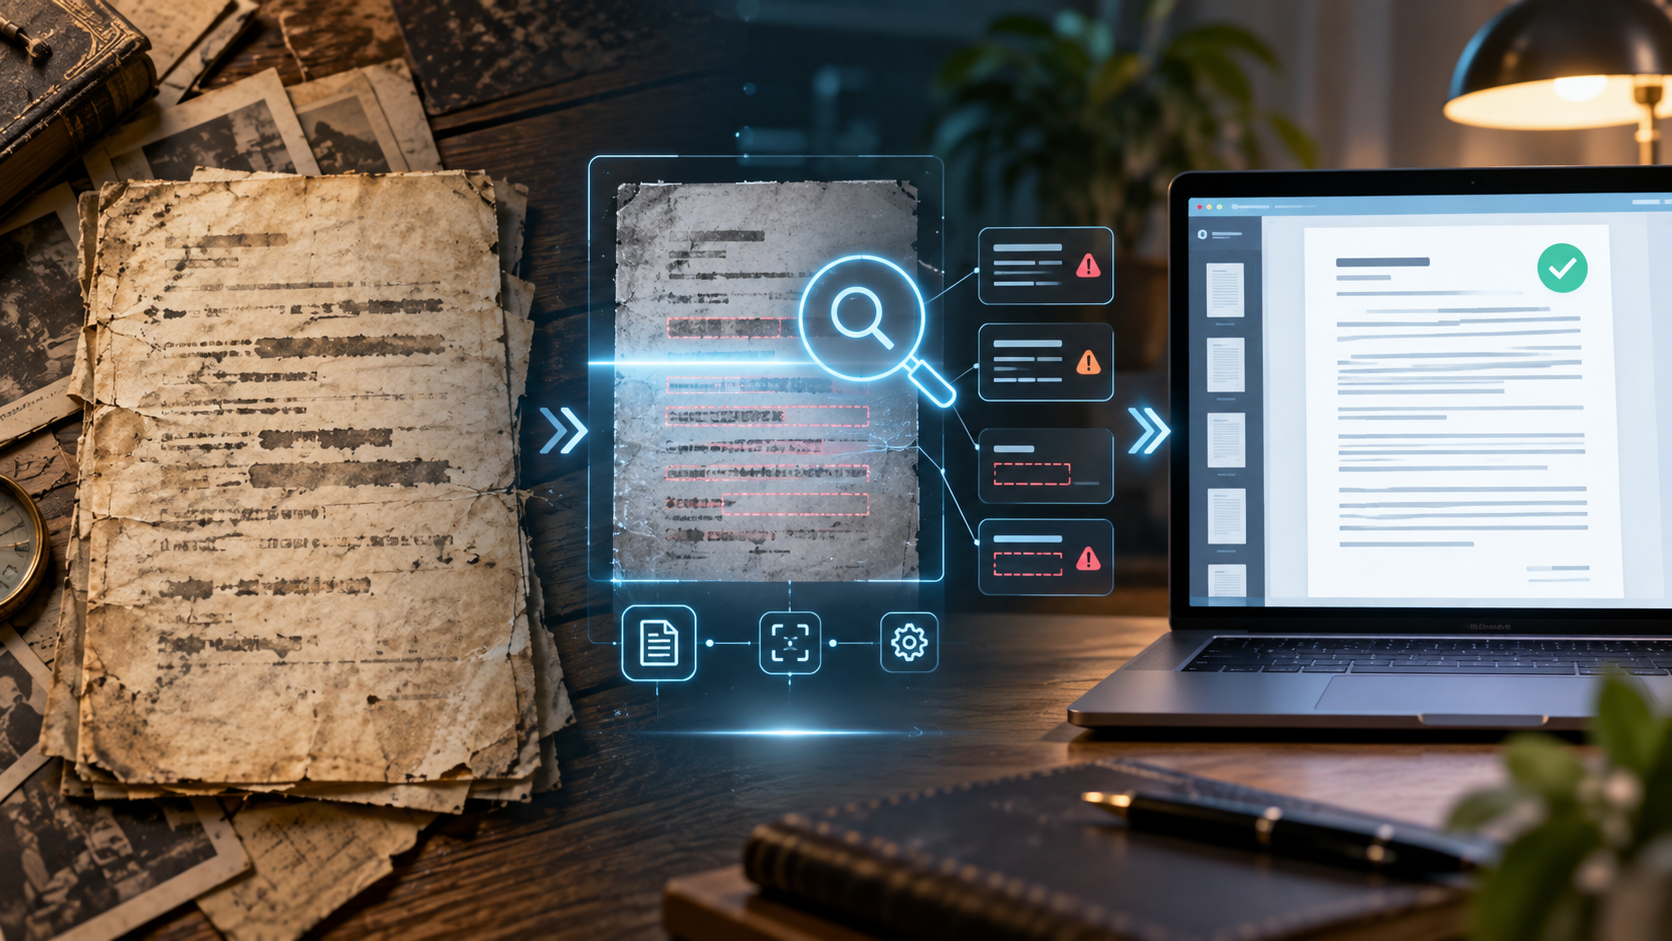
OCR, або оптичне розпізнавання символів, перетворює зображення документа на редагований текст. Проте технологія не «читає» сторінку так, як людина. Вона аналізує контури символів, контраст, структуру сторінки та ймовірні мовні послідовності. Якщо скан старий, нечіткий або має складне оформлення, система може пропустити цілі слова й рядки, об’єднати кілька колонок або замінити символи іншими.
Такі помилки особливо небезпечні в договорах, архівних матеріалах, протоколах, технічній документації та документах із датами, прізвищами й номерами. Навіть один пропущений рядок може змінити зміст абзацу. Тому якість OCR варто оцінювати не лише за тим, чи з’явився текст у файлі, а й за повнотою та відповідністю оригіналу.
Чому старий скан погано розпізнається
Проблема часто виникає ще до запуску OCR — на етапі створення зображення. Старий документ могли сканувати з копії, фотографувати телефоном або зберігати в стислому форматі з низькою роздільною здатністю. У результаті система отримує не чіткі літери, а спотворені плями та лінії.
- Низька роздільна здатність. Якщо висота літер становить лише кілька пікселів, OCR не може надійно розрізнити схожі символи.
- Розмиття. Рух під час сканування, несправний фокус або копіювання через кілька поколінь зменшують чіткість контурів.
- Нерівномірне освітлення. На фотографіях сторінки краї можуть бути темнішими, а центр — пересвіченим.
- Пожовклий або забруднений папір. Плями, складки й тіні іноді сприймаються як символи або, навпаки, перекривають текст.
- Нахил і деформація сторінки. Якщо аркуш зігнутий біля корінця, рядки в цій зоні викривляються.
- Складна верстка. Колонки, таблиці, рукописні дописки, печатки та підписи можуть збивати алгоритм аналізу структури.
- Неправильно вибрана мова. Для українського, російського, польського чи іншого тексту потрібні відповідні мовні моделі. Помилковий вибір призводить до плутанини символів і закінчень слів.
Як зрозуміти, що OCR пропускає текст
Найпростіша ознака — невідповідність кількості тексту на зображенні та в результаті розпізнавання. Якщо в оригіналі абзац має десять рядків, а в текстовому файлі залишилося сім, потрібно перевірити сторінку вручну. Не варто вважати результат правильним лише тому, що він виглядає грамотно: OCR може пропустити цілий фрагмент, а решта тексту залишиться читабельною.
Під час перевірки зверніть увагу на такі сигнали:
- речення раптово обриваються або починаються з малої літери;
- між двома абзацами зникає логічний перехід;
- у тексті немає заголовка, номера пункту чи підпису, які видно на скані;
- рядки таблиці злилися або частина комірок порожня;
- у результаті відсутні короткі слова, дати, індекси й позначення;
- кілька колонок прочитано в неправильному порядку;
- після копіювання тексту з PDF з’являються великі порожні ділянки.
Корисний метод контролю — порівнювати не лише окремі слова, а й структуру сторінки: заголовки, нумерацію, абзаци, списки, таблиці та примітки. Саме структурні пропуски часто залишаються непомітними під час швидкого вичитування.
Що перевірити в самому файлі
Перед повторним розпізнаванням відкрийте PDF або зображення та визначте, з яким типом документа маєте справу. У PDF може бути звичайне растрове зображення, прихований текстовий шар або змішаний файл, де частина сторінок уже розпізнана.
| Що перевірити | Як це впливає на OCR | Практична дія |
|---|---|---|
| Роздільну здатність | Дрібні літери втрачають форму | За можливості отримати якісніший скан або обробити сторінку без додаткового стискання |
| Нахил сторінки | Рядки визначаються нерівно, слова можуть зникати | Вирівняти зображення перед розпізнаванням |
| Контраст | Світлі символи зливаються з фоном | Обережно підсилити контраст і перевірити результат на копії |
| Колонки та таблиці | Текст читається в неправильній послідовності | Розпізнавати блоки окремо або вибрати режим макета сторінки |
| Мову документа | Схожі символи та слова визначаються неправильно | Встановити всі мови, які реально присутні на сторінці |
| Стан оригіналу | Плями й пошкодження створюють хибні символи | Очистити зображення програмно, не змінюючи оригінальний файл |
Підготовка скану перед розпізнаванням
Повторний запуск OCR на тому самому зображенні зазвичай не розв’язує проблему. Спочатку потрібно підготувати сторінку. Обробляйте копію, щоб зберегти первинний матеріал для подальшої перевірки.
1. Вирівняйте сторінку
Автоматичне виправлення нахилу допомагає, коли рядки відхиляються на кілька градусів. Для сторінок із сильними викривленнями може знадобитися ручне вирівнювання або корекція перспективи. Важливо не обрізати поля з номерами сторінок, примітками чи печатками.
2. Приберіть зайвий шум
Плями, пил, крапки та тіні можна зменшити за допомогою фільтрів очищення. Надмірна обробка небезпечна: тонкі лінії літер можуть зникнути, а літери з’єднатися в суцільні плями. Тому після кожної зміни порівнюйте оброблену копію з оригіналом.
3. Налаштуйте контраст і яскравість
Для чорно-білих машинописних документів іноді добре працює бінаризація — перетворення зображення на чорне й біле. Для пожовклого паперу або слабкого друку краще застосовувати її обережно, оскільки один поріг може стерти світлі символи.
4. Виберіть правильну область розпізнавання
Якщо на сторінці є кілька колонок, таблиця або текст поруч із печаткою, не завжди варто розпізнавати весь аркуш одним блоком. Окреме опрацювання текстових зон часто дає кращу послідовність і менше пропусків.
5. Не збільшуйте зображення без потреби
Масштабування може зробити перегляд комфортнішим, але не відновлює інформацію, якої немає в оригіналі. Збільшена розмита літера не стане чіткішою. Якщо вихідний скан дуже слабкий, ефективніше знайти інший примірник або зробити нове сканування.
Як повторно запускати OCR
Після підготовки сторінки варто протестувати кілька варіантів розпізнавання. Змінюйте лише один параметр за раз, щоб зрозуміти, що саме покращило результат.
- Встановіть правильну мову або комбінацію мов.
- Виберіть режим для одного текстового блоку, якщо сторінка має просту структуру.
- Для колонок застосуйте режим багатоколонкового документа або розділіть сторінку на частини.
- Для таблиць використовуйте інструмент, який розуміє комірки, або перевіряйте таблицю вручну.
- Порівняйте результат із зображенням, а не лише з попередньою версією тексту.
- Збережіть версію з помилками та виправлений текст окремо, щоб не втратити сліди редагування.
Якщо OCR постійно пропускає одну й ту саму ділянку, це може свідчити про фізичне пошкодження, тінь, складку або недостатню якість пікселів. У такому разі програмні налаштування не гарантують відновлення слова. Його потрібно звіряти з контекстом, іншими копіями або спорідненими сторінками, не видаючи припущення за точне прочитання.
Особливості старих машинописних і друкованих документів
У машинописних матеріалах символи часто мають нерівномірний натиск: одні літери темні, інші ледь помітні. Додаткові труднощі створюють зношені шрифтові елементи, плями від стрічки та нерівний інтервал між символами. OCR може плутати «і» та «ї», «о» та «а», цифри й літери, а також схожі символи латинки та кирилиці.
У старих друкованих виданнях проблеми виникають через фоновий шум, просвічування тексту з іншого боку аркуша, мікрофільмування або повторне копіювання. Якщо сторінка має дві колонки, перевірте, чи не прочитано кінець першої колонки після початку другої. Для газет, книжок і журналів також важливо відокремити основний текст від колонтитулів, приміток і номерів сторінок.
Як перевіряти результат після OCR
Перевірка має відповідати важливості документа. Для внутрішньої чернетки достатньо швидкого перегляду, а для архівного опису, договору чи публікації потрібна повна звірка з оригіналом.
- Перевірте початок і кінець кожної сторінки. Саме там текст часто обрізається через неправильні поля.
- Звірте всі числа. Дати, суми, номери пунктів і сторінок потрібно перевіряти окремо.
- Перечитайте власні назви. Прізвища, назви установ і населених пунктів можуть не розпізнатися за словником.
- Перевірте скорочення та абревіатури. Система може розділити їх на випадкові слова або вилучити крапки.
- Порівняйте заголовки й нумерацію. Пропущений номер пункту часто вказує на втрату рядка.
- Перегляньте таблиці та списки вручну. Лінії, відступи й комірки не завжди переносяться в текст правильно.
Для відповідальних матеріалів корисно вести журнал виправлень: зазначати сторінку, фрагмент, тип помилки та підставу для виправлення. Якщо слово неможливо впевнено прочитати, краще позначити його як нерозбірливе або додати редакторську примітку, ніж непомітно вгадувати.
Коли варто звернутися до фахівця
Професійна обробка доцільна, якщо документ має багато сторінок, складну структуру або високу цінність, а самостійне розпізнавання дає нестабільний результат. Фахівець може окремо підготувати зображення, налаштувати зони розпізнавання, виконати OCR і провести ручну вичитку. Це не означає, що будь-який пошкоджений фрагмент можна відновити: якість результату все одно обмежена станом оригіналу.
Перед передаванням матеріалів варто уточнити, у якому форматі потрібен результат: звичайний текст, DOCX, пошуковий PDF, таблиця або документ зі збереженням макета. Також важливо домовитися, чи входить до завдання ручна перевірка, опрацювання таблиць, збереження нерозбірливих місць і позначення сумнівних фрагментів.
Практичний алгоритм дій
- Збережіть оригінальний скан без змін.
- Перевірте, чи не обрізані краї, номери та примітки.
- Оцініть нахил, контраст, розмиття, плями й структуру сторінки.
- Створіть оброблену копію: вирівняйте, очистіть і за потреби скоригуйте контраст.
- Встановіть мову документа та відповідний режим макета.
- Розпізнайте сторінку або окремі блоки кількома варіантами.
- Порівняйте результат із зображенням рядок за рядком у важливих місцях.
- Виправте очевидні помилки, а сумнівні фрагменти позначте окремо.
- Збережіть фінальний текст і вихідні матеріали в різних файлах.
Для цього завдання CROWD пропонує послугу PDF / фото у Word.
Продовжити тему можна у статті OCR не бачить текст на фото: 10 причин поганого розпізнавання документа.
Часті запитання (FAQ)
Чи можна повністю відновити текст із дуже поганого скану?
Не завжди. OCR може покращити читабельність і допомогти відтворити частину тексту, але він не відновлює інформацію, якої немає на зображенні. Якщо літери стерті, перекриті плямою або мають сильне розмиття, частину фрагмента доведеться позначити як нерозбірливу або перевірити за іншою копією.
Чому OCR пропускає саме короткі слова?
Короткі слова займають мало пікселів і часто зливаються з шумом, лінією або сусіднім символом. Крім того, програма може вважати їх частиною іншого слова. Підвищення якості зображення, правильна мова та повторне розпізнавання окремого фрагмента іноді допомагають, але результат потрібно звіряти вручну.
Чи достатньо вибрати українську мову в налаштуваннях?
Це важливий, але не єдиний крок. На результат також впливають якість скану, нахил, формат сторінки, колонки, таблиці та стан шрифту. Якщо документ містить українську й латинську абетку, технічні позначення або іншу мову, варто врахувати це під час налаштування.
Чи можна виправляти помилки OCR автоматично?
Автоматична перевірка корисна для очевидних описок, але небезпечна для дат, прізвищ, номерів і спеціальних термінів. Словник може замінити рідкісне, але правильне слово на поширене неправильне. Автоматичні виправлення потрібно переглядати за оригіналом.
Як зрозуміти, що потрібно не повторювати OCR, а шукати інший скан?
Якщо після вирівнювання, очищення та зміни режимів одна й та сама ділянка залишається невидимою, проблема, найімовірніше, у вихідному зображенні. У такій ситуації краще знайти інший примірник, зробити нове сканування або залучити фахівця для ручної реконструкції лише там, де це можливо підтвердити.
Практична порада
Якщо матеріал має складне форматування, нерозбірливі фрагменти або спеціальні вимоги, краще узгодити формат результату до початку роботи.
Вам може бути цікаво
Потрібна професійна допомога?
Надішліть матеріал — ми оцінимо обсяг, строки та вартість роботи.