Приховані помилки після OCR: як очистити Word від м’яких переносів, табуляцій, нерозривних пробілів і зайвих розривів
Після розпізнавання PDF у Word текст може містити приховані символи, які непомітно змінюють переноси, вирівнювання та пошук. Розбираємо, як знайти й безпечно виправити м’які переноси, табуляції, нерозривні пробіли та зайві розриви рядків.
OCR дає змогу перетворити скан або PDF на редагований текст, але результат не завжди готовий до публікації. Навіть за правильно розпізнаних слів у документі можуть залишитися технічні символи: м’які переноси, табуляції, нерозривні пробіли, ручні розриви рядків і зайві абзаци. На екрані вони часто непомітні, проте впливають на пошук, копіювання, вирівнювання та подальше редагування.
Такі проблеми особливо часто виникають після розпізнавання багатосторінкових PDF, старих книжок, архівних документів і матеріалів зі складною версткою. У цій статті розглянемо, як виявити приховані символи після OCR у Microsoft Word, які заміни виконувати обережно та коли краще не очищати файл повністю автоматично.
Що таке приховані символи після OCR
Під час OCR програма аналізує не лише літери, а й структуру сторінки: рядки, абзаци, колонки, таблиці та переноси. Якщо оригінал є зображенням, алгоритм намагається відтворити його вигляд у текстовому форматі. У результаті Word може отримати не логічну структуру документа, а набір елементів, які приблизно повторюють розташування тексту на сторінці.
Приховані символи після OCR — це службові знаки або невидимі інтервали, які впливають на поведінку тексту. До них належать:
- м’який перенос — знак, що дозволяє переносити слово в певному місці, але не має відображатися, якщо слово поміщається в рядку;
- табуляція — службовий відступ, який може використовуватися замість звичайних пробілів;
- нерозривний пробіл — пробіл, що не дозволяє розділити два сусідні фрагменти під час перенесення рядка;
- ручний розрив рядка — перехід на новий рядок без створення нового абзацу;
- зайві абзаци — повторювані знаки кінця абзацу, які утворюють порожні рядки;
- залишки форматування — непослідовні відступи, інтервали, стилі та вирівнювання.
Не кожен такий знак є помилкою. Наприклад, нерозривний пробіл потрібен у датах, числах із одиницями вимірювання, ініціалах і деяких назвах. Тому очищення має бути не механічним, а контекстним.
Як побачити приховані символи у Word
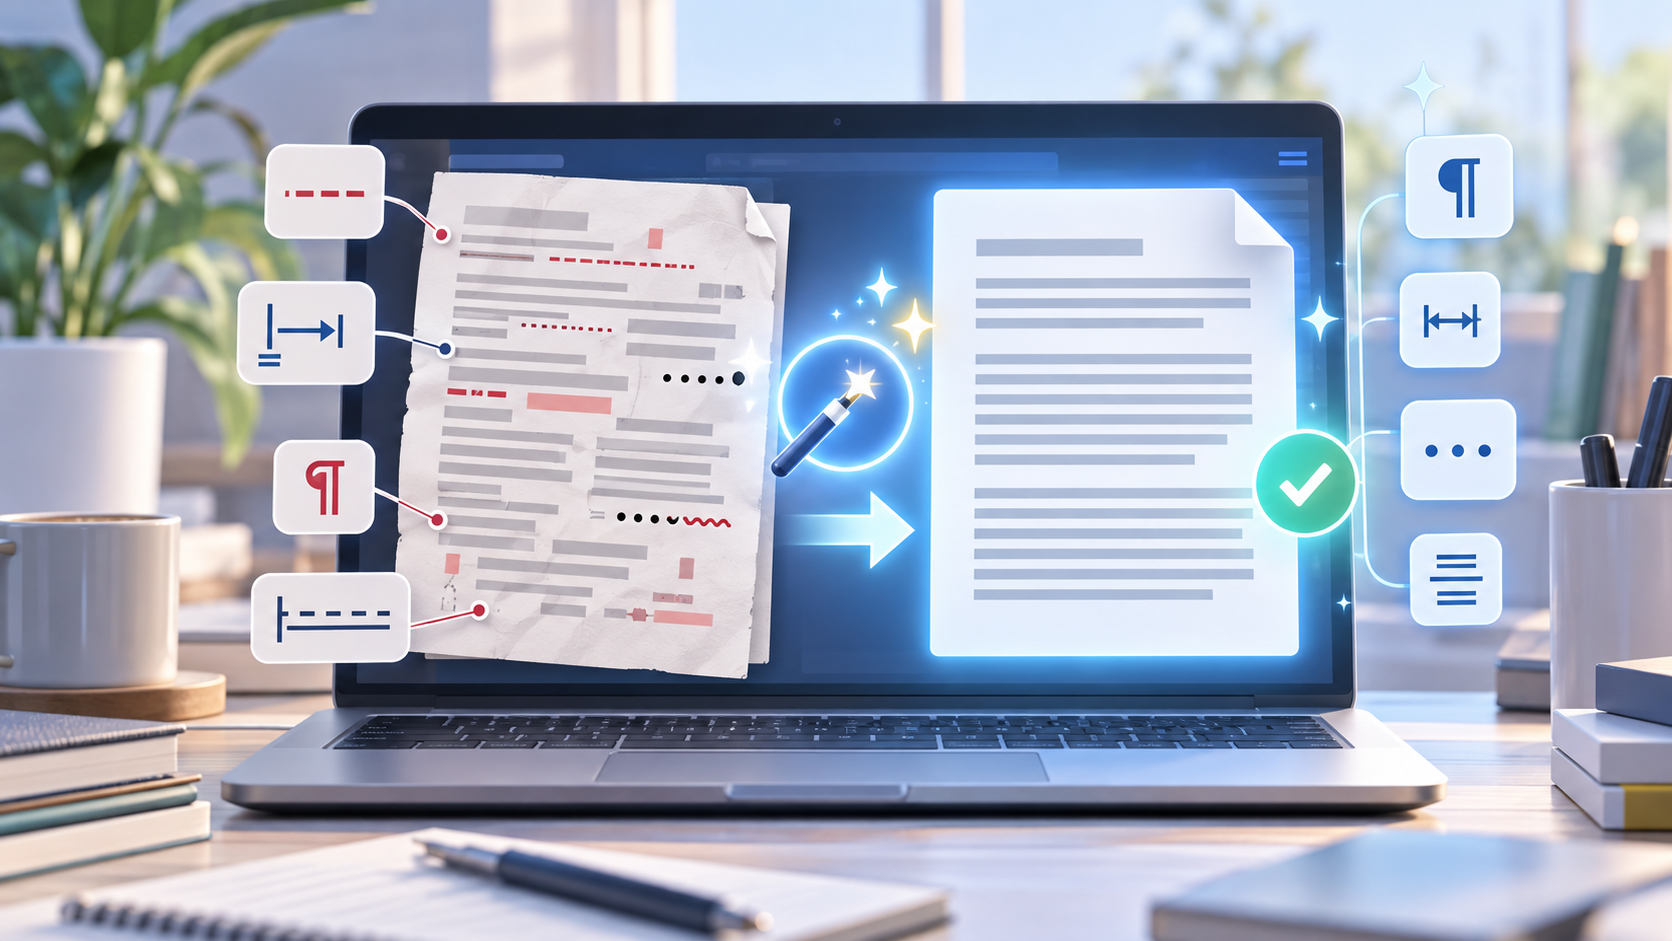
Перший крок — увімкнути відображення недрукованих знаків. У Word це можна зробити кнопкою ¶ на вкладці «Основне» або клавішами Ctrl+Shift+8. Після цього програма покаже службові позначки, які не друкуються разом із текстом.
Зазвичай користувач побачить:
- крапки на місці звичайних пробілів;
- стрілки на місці табуляцій;
- знак абзацу ¶ наприкінці кожного абзацу;
- зігнуту стрілку для ручного розриву рядка;
- інші спеціальні позначення, залежно від версії Word і налаштувань документа.
Окрім візуальної перевірки, скористайтеся пошуком і заміною: Ctrl+H. У полі пошуку Word можна використовувати спеціальні коди. Вони допомагають знаходити повторювані проблеми в довгому документі, але перед масовою заміною варто зберегти резервну копію.
Основні помилки та способи їх виправлення
М’які переноси
М’який перенос, або soft hyphen, може залишатися в середині слова після OCR. Він часто з’являється там, де на скані слово було розділене наприкінці рядка. У звичайному режимі знак може бути невидимим, але впливати на пошук: слово, скопійоване з документа, іноді не збігається з тим самим словом, введеним вручну.
М’який перенос також може створювати проблеми під час експорту в інший формат, індексації тексту та перевірки орфографії. Якщо документ не має зберігати автоматичне переносіння слів, такі знаки зазвичай доцільно видалити.
У Word можна відкрити «Знайти й замінити» та використати спеціальний код м’якого переносу, якщо він підтримується конкретною версією програми. У полі пошуку часто застосовують позначення ^-. Перед заміною перевірте результат на кількох сторінках: у складно відформатованих файлах перенос може бути частиною свідомо заданої верстки.
Не плутайте м’який перенос із дефісом. Звичайний дефіс є видимим символом і може бути частиною слова, наприклад у складних термінах. Безпідставне видалення всіх дефісів зіпсує текст.
Табуляції
OCR часто замінює відстань між елементами сторінки табуляціями. Наприклад, у рядку з реквізитами програма може додати кілька табуляторів замість правильної таблиці або відступів. Візуально такий текст може виглядати прийнятно, але після зміни шрифту, полів чи ширини сторінки все вирівнювання порушиться.
Окрема проблема — табуляції на початку абзаців. Вони створюють нерівномірні відступи й заважають застосувати стилі Word. Якщо табуляція не має структурної функції, її можна замінити одним пробілом або видалити. У пошуку Word табуляція позначається кодом ^t.
Масова заміна всіх табуляцій на пробіли без перевірки небезпечна. Вона може зруйнувати таблиці, списки, колонтитули або блоки з підписами. У фрагментах, де дані розташовані по колонках, краще перетворити їх на справжню таблицю Word або вирівняти за допомогою стилів.
Нерозривні пробіли
Нерозривний пробіл, Unicode-символ U+00A0, не дає Word перенести сусідні слова на різні рядки. Він доречний, наприклад, між числом і одиницею вимірювання: «25 кг», між ініціалами та прізвищем, а також у деяких скороченнях.
Після OCR нерозривні пробіли можуть з’являтися там, де їх не було, або змішуватися зі звичайними пробілами. Через це пошук фрази може не знаходити потрібний фрагмент, а подвійні пробіли стають складнішими для виявлення.
У Word нерозривний пробіл у вікні пошуку часто позначається кодом ^s. Не варто автоматично замінювати всі такі знаки на звичайні пробіли: це може зіпсувати оформлення чисел, дат і професійних текстів. Безпечніше спочатку знайти їх, переглянути контекст і лише потім замінювати вибірково або за чітким правилом.
Ручні розриви рядків
Ручний розрив рядка переводить текст на новий рядок, але не створює нового абзацу. Після OCR він часто з’являється наприкінці кожного рядка сканованої сторінки. У такому випадку один логічний абзац у Word може складатися з десятків коротких рядків.
Це ускладнює редагування, адаптацію тексту під іншу ширину сторінки та пошук фраз. Для ручного розриву рядка у Word використовується код ^l, а для кінця абзацу — ^p.
Якщо потрібно об’єднати рядки в абзаци, не можна просто замінити всі ^l на пробіли. Розриви можуть бути потрібні в адресах, віршах, заголовках, списках або підписах. Спочатку визначте, як побудований документ, і обробляйте окремі типи блоків.
Зайві розриви абзаців
Порожні рядки часто з’являються, коли OCR намагається відтворити вертикальні проміжки між блоками. Інколи два або три знаки абзацу поспіль використовуються замість налаштування інтервалів у стилі.
Для пошуку повторюваних абзаців можна перевіряти комбінацію ^p^p і замінювати її на один знак абзацу. Однак цю операцію краще повторювати з переглядом результату: у документах із формами, бланками або розділенням структурних блоків порожній рядок може мати функціональне значення.
Коротка таблиця кодів Word
| Елемент | Як виглядає | Код у «Знайти й замінити» | Що перевірити |
|---|---|---|---|
| Табуляція | Стрілка вправо | ^t | Чи не формує вона таблицю або відступ |
| Кінець абзацу | ¶ | ^p | Чи немає повторюваних порожніх абзаців |
| Ручний розрив рядка | Зігнута стрілка | ^l | Чи є рядки частиною одного абзацу |
| Нерозривний пробіл | Спеціальна позначка пробілу | ^s | Чи потрібен нерозривний зв’язок слів |
| М’який перенос | Зазвичай невидимий | ^- | Чи це перенос, а не звичайний дефіс |
Безпечний алгоритм очищення документа
Щоб не пошкодити зміст і структуру, очищуйте OCR-документ у кілька етапів.
- Створіть копію. Збережіть оригінальний файл окремо. Після серії замін повернути попередній стан іноді складно.
- Перевірте якість розпізнавання. Очищення символів не виправляє помилки в літерах, цифрах, власних назвах і розділових знаках.
- Увімкніть недруковані знаки. Перегляньте кілька типових сторінок, а не лише початок документа.
- Знайдіть повторювані проблеми. Використовуйте Ctrl+H і перевіряйте окремі збіги перед масовою заміною.
- Спочатку обробіть очевидні технічні помилки. Наприклад, зайві пробіли або подвійні абзаци в суцільному тексті.
- Окремо перевірте таблиці, списки та заголовки. Саме ці елементи найчастіше руйнуються після глобальних замін.
- Застосуйте стилі. Для заголовків, основного тексту, списків і цитат краще використовувати стилі Word, а не ручні відступи.
- Проведіть фінальну перевірку. Перегляньте пошук за ключовими словами, нумерацію сторінок, таблиці, колонтитули та текст після експорту.
Якщо PDF має складну верстку, колонки або багато таблиць, автоматичне очищення може бути недостатнім. У таких випадках краще спочатку виконати конвертацію PDF у Word з перевіркою структури, а потім редагувати текст блоками.
Коли не варто очищати все автоматично
Глобальна заміна корисна для однотипних документів, але ризикована для юридичних, технічних, архівних і дизайнерських матеріалів. Під час автоматичного очищення можуть зникнути значущі відступи, розділення рядків, елементи формул або зв’язок між числом і одиницею вимірювання.
Обережність потрібна також у поетичних текстах, сценаріях, анкетах і документах, де кожен рядок має окреме значення. У них ручний розрив може бути не помилкою OCR, а частиною оригінального оформлення.
Для важливого документа корисно порівняти очищений Word із вихідним PDF посторінково. Мета не в тому, щоб прибрати всі службові символи, а в тому, щоб зберегти зміст, логіку та зручність подальшої роботи.
Практичні поради для якісного результату
- Не виправляйте форматування до перевірки тексту: спочатку переконайтеся, що OCR правильно розпізнав слова й цифри.
- Для довгих документів працюйте розділами або копіями окремих фрагментів.
- Після замін перевіряйте не лише вигляд, а й копіювання тексту, пошук і поведінку під час експорту в PDF.
- Не використовуйте багато пробілів для вирівнювання. Застосовуйте таблиці, відступи, табулятори з заданими позиціями або стилі.
- Якщо документ має повторюваний шаблон, спочатку протестуйте правила на кількох сторінках.
- Для конфіденційних матеріалів перевірте, де саме обробляються файли та які правила зберігання даних діють у вибраному сервісі.
Детальніше про професійне виконання цієї роботи — PDF / фото у Word.
Ще один корисний матеріал за темою — OCR не бачить текст на фото: 10 причин поганого розпізнавання документа.
Часті запитання (FAQ)
Чи потрібно видаляти всі приховані символи після OCR?
Ні. Частина з них може бути потрібна для правильної структури документа. Видаляйте лише ті символи, які спричиняють конкретну проблему: неправильні переноси, зламаний пошук, нерівномірні відступи або зайві порожні рядки.
Чим м’який перенос відрізняється від дефіса?
Дефіс є видимим знаком і може бути частиною слова. М’який перенос зазвичай невидимий і використовується для можливого перенесення слова в кінці рядка. Під час очищення їх не можна обробляти однаково.
Чому Word не знаходить слово, яке видно на екрані?
Причиною може бути м’який перенос, нерозривний пробіл, зайвий службовий знак або помилка OCR у самій літері. Увімкніть недруковані символи, скопіюйте фрагмент у простий текстовий редактор і перевірте його посимвольно.
Чи можна замінити всі ручні розриви рядків на пробіли?
Лише після перевірки структури. У суцільному тексті це часто допомагає об’єднати рядки в абзаци, але в адресах, списках, віршах і формах може зруйнувати оригінальне форматування.
Що робити, якщо після очищення зламалися таблиці?
Скасуйте масову заміну або відкрийте резервну копію. Далі обробляйте звичайний текст і таблиці окремо. Дані, які OCR відтворив за допомогою пробілів і табуляцій, часто краще перенести у справжню таблицю Word.
Чи усуває конвертація PDF у Word усі приховані символи?
Ні. Конвертація створює редагований документ, але його якість залежить від вихідного PDF, якості сканування, шрифтів і складності верстки. Після перетворення потрібні перевірка та редакторське очищення.
Висновок
Приховані символи після OCR не завжди видно, але вони можуть суттєво впливати на якість Word-документа. М’які переноси заважають пошуку, табуляції створюють нестабільне вирівнювання, нерозривні пробіли змінюють поведінку рядків, а ручні розриви перетворюють абзаци на набір коротких фрагментів.
Найнадійніший підхід — працювати з копією файлу, увімкнути недруковані знаки, перевіряти контекст і застосовувати заміни поетапно. Якщо документ складний або має високу цінність, автоматичні операції варто поєднувати з ручною вичиткою та порівнянням із вихідним PDF.
Практична порада
Якщо матеріал має складне форматування, нерозбірливі фрагменти або спеціальні вимоги, краще узгодити формат результату до початку роботи.
Вам може бути цікаво
Потрібна професійна допомога?
Надішліть матеріал — ми оцінимо обсяг, строки та вартість роботи.